
视频里已经压好的字幕,怎么才能变成可编辑的文字稿?这是不少内容工作者反复遇到的问题——重新听打耗时太长,在线工具又担心素材外泄。本次推荐的视频内嵌字幕提取工具正是针对这一需求:它在本地完成识别,不需要联网上传视频,通过框选字幕区域并设置采样参数,自动输出带时间轴的结构化字幕内容。
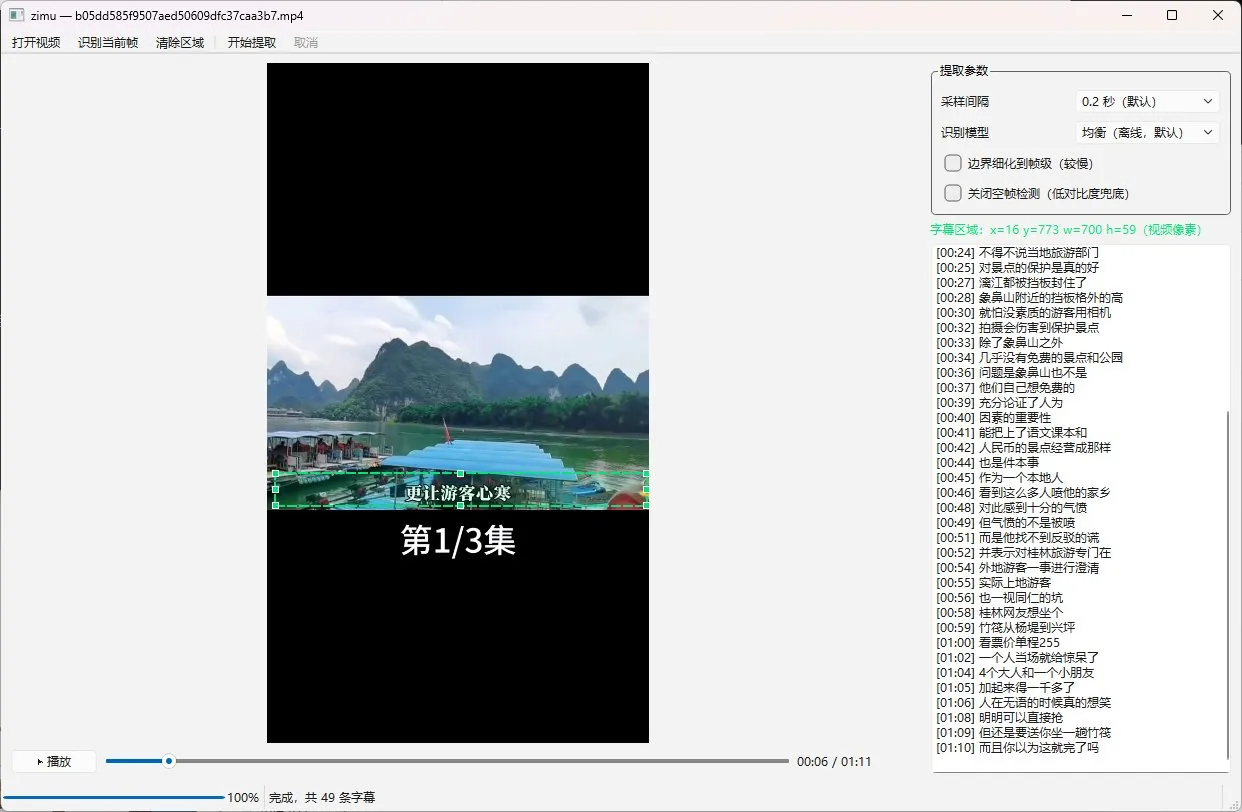
视频内嵌字幕提取工具
工具的核心逻辑并不复杂:播放视频时按固定间隔抓取画面,对指定区域做文字识别,再按时间顺序合并成字幕列表。它内置边界细化与空帧检测,能在低对比度字幕场景下减少漏识和误识。下面按不同使用场景拆解它的实际用法。
场景一:自媒体二次创作整理口播文案
做解说、混剪或搬运类内容时,经常需要把参考视频的字幕扒下来做文案底稿。人工逐句暂停抄写,一集几分钟的视频就要花掉半小时以上。用这个工具,把字幕区域框在屏幕下方对应位置,采样间隔保持默认的0.2秒,点击开始提取即可。
- 识别模型可选均衡模式,离线运行不依赖网络
- 提取完成后直接得到带时间轴的文字列表,方便二次剪辑对轴
- 进度以百分比显示,完成条数一目了然
提示:如果视频字幕带描边或背景色块,建议先框选稍大一点的区域,避免文字边缘被裁掉导致识别率下降。
场景二:办公人员转写会议录像与培训视频
企业内部培训录像、线上会议回放往往自带字幕条,但字幕无法直接复制。这类场景对准确率要求高,对速度要求相对宽松。此时可以把采样间隔调小,让工具在字幕切换的关键帧多抓取几次,减少整句漏字。
框选范围要覆盖字幕可能出现的最宽位置,特别是中英文混排的培训视频,字幕长度变化较大。工具支持手动输入坐标精确设定区域,对于分辨率固定的录屏文件,一次设置可以批量复用。
- 离线识别,会议内容不经过第三方服务器
- 输出结果含时间戳,便于按时间点定位原视频画面
- 支持清除区域重新框选,适应不同版式的录像
场景三:学习用户提取课程字幕做笔记
网课、讲座视频的字幕是现成的复习材料,但多数平台不提供导出功能。用该工具把字幕提取成文本后,可以直接导入笔记软件做标注和检索。对于语速平稳的课程视频,均衡模型已经足够;如果讲师语速快、字幕切换频繁,可以适当减小采样间隔。
提示:课程视频如果分多集,建议每集单独提取,文件名带上集数,后续整理时不会混淆时间轴。
参数设置与适用边界
工具提供两个关键参数:采样间隔和识别模型。采样间隔决定每隔多久抓一帧画面,默认0.2秒适合大多数常规字幕;识别模型提供均衡模式,在离线状态下兼顾速度与准确率。字幕区域通过框选或手动输入坐标确定,区域越贴合字幕实际位置,误识别越少。
- 边界细化:优化字幕文字边缘的识别精度
- 空帧检测:跳过没有字幕的画面,减少无效识别
- 进度显示:完成百分比与已提取条数同步更新
需要说明的是,该工具针对的是硬字幕——即已经烧录在画面中的文字。外挂字幕文件本身就可直接读取,不需要走识别流程。另外,字幕字号过小或与背景色差过低时,识别率会受到影响,此时可以尝试调整采样间隔或重新框选区域。
获取方式与使用建议
这份视频内嵌字幕提取工具资源已在站内提供免费下载,包含完整的操作界面与识别模块,本地解压即可运行,无需额外配置环境。首次使用时建议先用一段短字幕视频测试框选位置和采样参数,确认识别效果后再处理长视频,能省下不少重复调整的时间。
对于需要频繁处理视频字幕的创作者和办公用户,把它放进常用工具目录,配合简单的文件命名规则,基本可以替代手工听打的流程。资源免费提供,按需取用即可。